0. イントロ
確率論や統計学では、ランダムな量の値そのものよりも、その量が典型的な値からどの程度ずれうるかを知りたい場面がよくあります。
例として、独立同分布(independent and identically distributed; i.i.d.)な確率変数 X 1 , … , X n X_1, \dots, X_n X 1 , … , X n
X ˉ n : = 1 n ∑ i = 1 n X i \bar{X}_n := \frac{1}{n} \sum_{i=1}^n X_i X ˉ n := n 1 i = 1 ∑ n X i を考えます。
E [ ∣ X 1 ∣ ] < ∞ \mathbb{E}[|X_1|] < \infty E [ ∣ X 1 ∣ ] < ∞ n → ∞ n \to \infty n → ∞ X ˉ n \bar{X}_n X ˉ n μ : = E [ X 1 ] \mu := \mathbb{E}[X_1] μ := E [ X 1 ] 1 1 1 n n n n n n ε > 0 \varepsilon > 0 ε > 0
Pr ( ∣ X ˉ n − μ ∣ ≥ ε ) \Pr\left(|\bar{X}_n - \mu| \geq \varepsilon\right) Pr ( ∣ X ˉ n − μ ∣ ≥ ε ) この確率を、n n n ε \varepsilon ε 集中不等式(concentration inequality) と呼びます。
中心極限定理も X ˉ n \bar{X}_n X ˉ n n → ∞ n \to \infty n → ∞ n n n n n n
本記事で使う例:成功確率の推定
本記事では、次の問題を例にして各不等式を比較します。
成功確率 p p p n n n i i i X i = 1 X_i = 1 X i = 1 X i = 0 X_i = 0 X i = 0 p p p p ^ : = 1 n ∑ i = 1 n X i \hat{p} := \frac{1}{n} \sum_{i=1}^n X_i p ^ := n 1 ∑ i = 1 n X i ε \varepsilon ε δ \delta δ n n n
条件は次の 2 つとし、それぞれ δ = 0.05 \delta = 0.05 δ = 0.05 δ = 10 − 6 \delta = 10^{-6} δ = 1 0 − 6
(A) p = 0.5 p = 0.5 p = 0.5 ε = 0.05 \varepsilon = 0.05 ε = 0.05 p ( 1 − p ) p(1-p) p ( 1 − p ) 1 / 4 1/4 1/4 (B) p = 0.01 p = 0.01 p = 0.01 ε = 0.005 \varepsilon = 0.005 ε = 0.005 p ( 1 − p ) ≈ 0.0099 p(1-p) \approx 0.0099 p ( 1 − p ) ≈ 0.0099
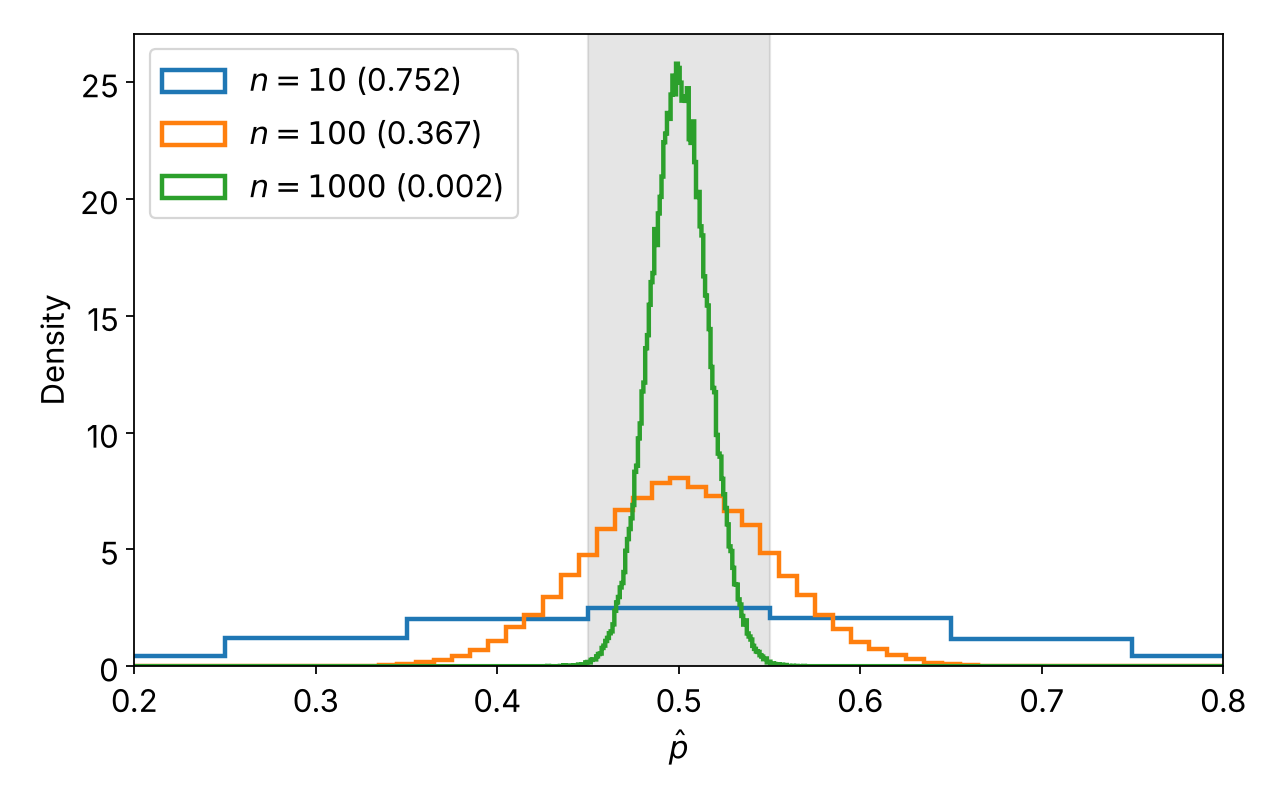
まず、(A) の条件で p ^ \hat{p} p ^ n = 10 , 100 , 1000 n = 10, 100, 1000 n = 10 , 100 , 1000 p ^ \hat{p} p ^ 10 5 10^5 1 0 5
import numpy as np
import matplotlib . pyplot as plt
rng = np . random . default_rng ( 0 )
p , eps , trials = 0.5 , 0.05 , 100_000
for n in [ 10 , 100 , 1000 ] :
# 成功確率 p の試行を n 回行ったときの成功割合を trials 回分生成する
p_hat = rng . binomial ( n , p , size = trials ) / n
# 誤差が eps 以上になった割合(1e-12 は浮動小数点の丸め誤差対策)
miss = np . mean ( np . abs ( p_hat - p ) >= eps - 1e-12 )
bins = ( np . arange ( n + 2 ) - 0.5 ) / n # 各 k/n を中心とする幅 1/n のビン
plt . hist ( p_hat , bins = bins , density = True , histtype = "step" , lw = 2 ,
label = f"$n = { n } $ ( { miss : .3f } )" )
plt . axvspan ( p - eps , p + eps , color = "gray" , alpha = 0.2 )
plt . xlim ( 0.2 , 0.8 )
plt . xlabel ( r"$\hat p$" )
plt . ylabel ( "Density" )
plt . legend ( loc = "upper left" )
plt . show ( ) 図 1:(A) の条件(p = 0.5)での成功割合の分布。灰色の帯は |p̂ − p| < 0.05 の範囲、凡例の括弧内は誤差が 0.05 以上になった割合。 図 1 のように、n n n p ^ \hat{p} p ^ p = 0.5 p = 0.5 p = 0.5 0.05 0.05 0.05 n = 10 n = 10 n = 10 0.752 0.752 0.752 n = 100 n = 100 n = 100 0.367 0.367 0.367 n = 1000 n = 1000 n = 1000 0.002 0.002 0.002
記事中にコードを載せていない図 2 と図 5 も含め、本記事のすべての図は code/concentration/make_figures.py で再生成できます。
本記事のロードマップ
各節で扱う不等式と、その不等式が使う情報は次のとおりです。
Markov の不等式 (第 2 節):非負性と期待値Chebyshev の不等式 (第 3 節):分散Chernoff 法 (第 4 節):積率母関数Hoeffding の不等式 (第 5 節):独立性と値域Bernstein の不等式 (第 6 節):独立性、値域、分散McDiarmid の不等式 (第 7 節):独立性と、1 つの入力を変えたときの出力の変化の上限
第 8 節で例の結果を比較し、第 9 節で仮定が満たされない場合の道具を紹介します。
後の節の不等式ほど常に強いわけではありません。
どの不等式が小さい上界を与えるかは、使える仮定と問題の条件によって変わります。
1. 記法と基本事項
Pr ( A ) \Pr(A) Pr ( A ) A A A E [ X ] \mathbb{E}[X] E [ X ] X X X Var ( X ) : = E [ ( X − E [ X ] ) 2 ] \operatorname{Var}(X) := \mathbb{E}[(X - \mathbb{E}[X])^2] Var ( X ) := E [( X − E [ X ] ) 2 ] 1 A \mathbf{1}_A 1 A A A A A A A 1 1 1 0 0 0 「X ≥ 0 X \geq 0 X ≥ 0 1 1 1 X ≥ 0 X \geq 0 X ≥ 0
確率変数 X 1 , … , X n X_1, \dots, X_n X 1 , … , X n S n : = ∑ i = 1 n X i S_n := \sum_{i=1}^n X_i S n := ∑ i = 1 n X i X ˉ n : = S n / n \bar{X}_n := S_n / n X ˉ n := S n / n
log \log log 裾確率と union bound
確率変数 X X X t > 0 t > 0 t > 0 裾確率(tail probability) と呼びます。
離れる向きによって、次の 3 種類があります。
上側の裾確率:Pr ( X − E [ X ] ≥ t ) \Pr(X - \mathbb{E}[X] \geq t) Pr ( X − E [ X ] ≥ t )
下側の裾確率:Pr ( X − E [ X ] ≤ − t ) \Pr(X - \mathbb{E}[X] \leq -t) Pr ( X − E [ X ] ≤ − t )
両側の裾確率:Pr ( ∣ X − E [ X ] ∣ ≥ t ) \Pr(|X - \mathbb{E}[X]| \geq t) Pr ( ∣ X − E [ X ] ∣ ≥ t )
集中不等式は、これらの裾確率の上界(tail bound)を与えます。
任意の事象 A , B A, B A , B Pr ( A ∪ B ) ≤ Pr ( A ) + Pr ( B ) \Pr(A \cup B) \leq \Pr(A) + \Pr(B) Pr ( A ∪ B ) ≤ Pr ( A ) + Pr ( B ) 2 2 2
2. Markov の不等式
Markov の不等式は、非負性と期待値だけから裾確率を評価します。
本記事の残りの不等式は、いずれも証明のどこかでこの不等式を使います。
X ≥ 0 X \geq 0 X ≥ 0 E [ X ] < ∞ \mathbb{E}[X] < \infty E [ X ] < ∞ t > 0 t > 0 t > 0
Pr ( X ≥ t ) ≤ E [ X ] t \Pr(X \geq t) \leq \frac{\mathbb{E}[X]}{t} Pr ( X ≥ t ) ≤ t E [ X ] が成り立ちます。
証明 X ≥ 0 X \geq 0 X ≥ 0 1 1 1 X ≥ t 1 { X ≥ t } X \geq t \mathbf{1}_{\{X \geq t\}} X ≥ t 1 { X ≥ t } X ≥ t X \geq t X ≥ t t t t 0 0 0 E [ X ] ≥ t Pr ( X ≥ t ) \mathbb{E}[X] \geq t \Pr(X \geq t) E [ X ] ≥ t Pr ( X ≥ t ) t t t □ \square □
t = c E [ X ] t = c\, \mathbb{E}[X] t = c E [ X ] c > 0 c > 0 c > 0 Pr ( X ≥ c E [ X ] ) ≤ 1 / c \Pr(X \geq c\, \mathbb{E}[X]) \leq 1/c Pr ( X ≥ c E [ X ]) ≤ 1/ c 10 10 10 1 / 10 1/10 1/10 t t t 1 / t 1/t 1/ t
指示関数を非負の関数で抑える
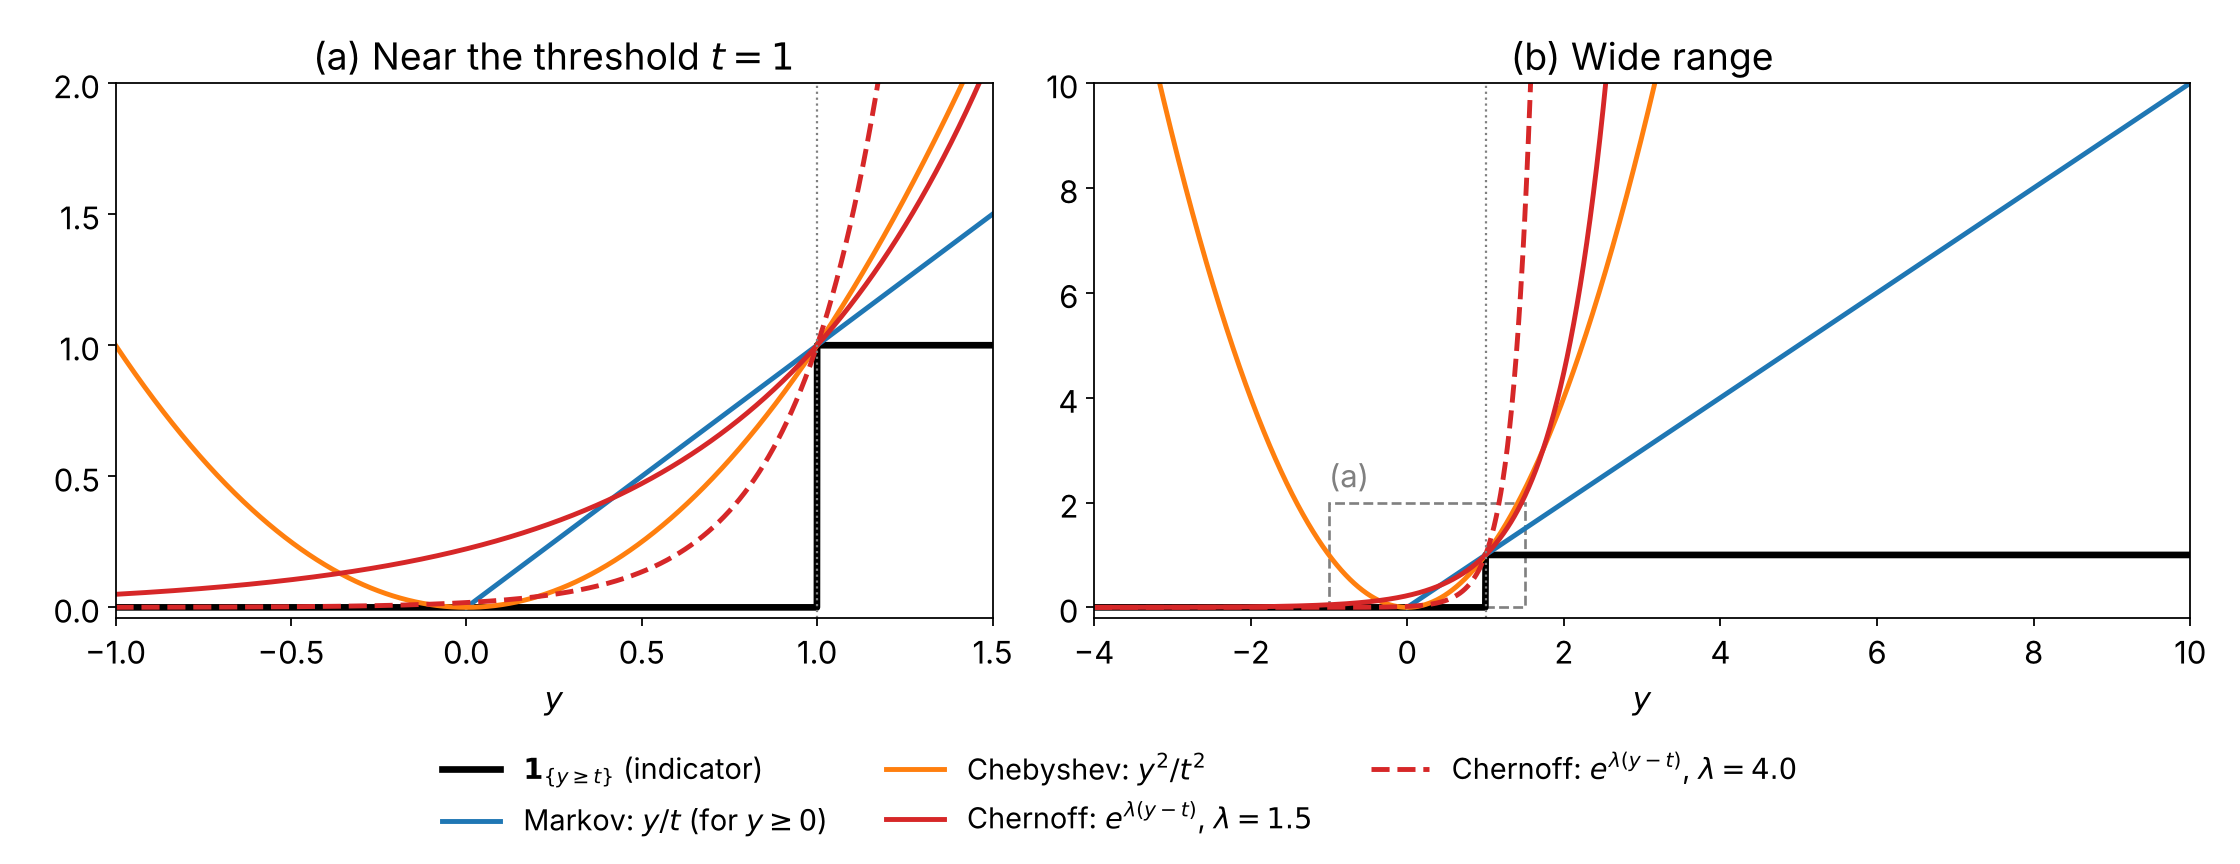
証明で使ったのは、指示関数 1 { X ≥ t } \mathbf{1}_{\{X \geq t\}} 1 { X ≥ t } Y Y Y φ \varphi φ Y Y Y y y y φ ( y ) ≥ 1 { y ≥ t } \varphi(y) \geq \mathbf{1}_{\{y \geq t\}} φ ( y ) ≥ 1 { y ≥ t }
Pr ( Y ≥ t ) = E [ 1 { Y ≥ t } ] ≤ E [ φ ( Y ) ] \Pr(Y \geq t) = \mathbb{E}\left[\mathbf{1}_{\{Y \geq t\}}\right] \leq \mathbb{E}[\varphi(Y)] Pr ( Y ≥ t ) = E [ 1 { Y ≥ t } ] ≤ E [ φ ( Y )] が成り立ちます。
φ \varphi φ
図 2:指示関数 1{y ≥ t}(黒、t = 1)を上から抑える非負の関数。(a) は t の近く、(b) は広い範囲で、(b) の破線の枠が (a) の範囲。Markov の不等式は y/t(y ≥ 0 の場合)、Chebyshev の不等式は y²/t²、Chernoff 法は exp(λ(y − t)) を使う。
Markov の不等式 (第 2 節):非負の Y = X Y = X Y = X φ ( y ) = y / t \varphi(y) = y/t φ ( y ) = y / t Chebyshev の不等式 (第 3 節):Y = X − E [ X ] Y = X - \mathbb{E}[X] Y = X − E [ X ] φ ( y ) = y 2 / t 2 \varphi(y) = y^2/t^2 φ ( y ) = y 2 / t 2 φ \varphi φ y ≤ − t y \leq -t y ≤ − t 1 1 1 Chernoff 法 (第 4 節):Y = X − E [ X ] Y = X - \mathbb{E}[X] Y = X − E [ X ] φ ( y ) = e λ ( y − t ) \varphi(y) = e^{\lambda(y - t)} φ ( y ) = e λ ( y − t ) λ > 0 \lambda > 0 λ > 0
Y Y Y φ \varphi φ λ \lambda λ φ \varphi φ t t t λ = 4 \lambda = 4 λ = 4 λ = 1.5 \lambda = 1.5 λ = 1.5 y < t y < t y < t y > t y > t y > t λ \lambda λ
図 2 (b) の広い範囲では、遠くでの増え方の違いが分かります。
Markov の不等式の y / t y/t y / t y y y y 2 / t 2 y^2/t^2 y 2 / t 2 0 0 0 e λ ( y − t ) e^{\lambda(y - t)} e λ ( y − t ) y y y 0 0 0 y > t y > t y > t E [ φ ( Y ) ] \mathbb{E}[\varphi(Y)] E [ φ ( Y )] Y Y Y Y Y Y
3. Chebyshev の不等式
Chebyshev の不等式は、分散を使って期待値の周りへの集中を評価します。
X X X Var ( X ) \operatorname{Var}(X) Var ( X ) t > 0 t > 0 t > 0
Pr ( ∣ X − E [ X ] ∣ ≥ t ) ≤ Var ( X ) t 2 \Pr(|X - \mathbb{E}[X]| \geq t) \leq \frac{\operatorname{Var}(X)}{t^2} Pr ( ∣ X − E [ X ] ∣ ≥ t ) ≤ t 2 Var ( X ) が成り立ちます。
証明 非負の確率変数 ( X − E [ X ] ) 2 (X - \mathbb{E}[X])^2 ( X − E [ X ] ) 2
Pr ( ∣ X − E [ X ] ∣ ≥ t ) = Pr ( ( X − E [ X ] ) 2 ≥ t 2 ) ≤ E [ ( X − E [ X ] ) 2 ] t 2 = Var ( X ) t 2 \begin{aligned}
\Pr(|X - \mathbb{E}[X]| \geq t)
&= \Pr\left((X - \mathbb{E}[X])^2 \geq t^2\right) \\
&\leq \frac{\mathbb{E}\left[(X - \mathbb{E}[X])^2\right]}{t^2}
= \frac{\operatorname{Var}(X)}{t^2}
\end{aligned} Pr ( ∣ X − E [ X ] ∣ ≥ t ) = Pr ( ( X − E [ X ] ) 2 ≥ t 2 ) ≤ t 2 E [ ( X − E [ X ] ) 2 ] = t 2 Var ( X ) を得ます。□ \square □
標本平均への適用
X 1 , … , X n X_1, \dots, X_n X 1 , … , X n μ \mu μ σ 2 \sigma^2 σ 2 Var ( X ˉ n ) = σ 2 / n \operatorname{Var}(\bar{X}_n) = \sigma^2/n Var ( X ˉ n ) = σ 2 / n
Pr ( ∣ X ˉ n − μ ∣ ≥ ε ) ≤ σ 2 n ε 2 \Pr(|\bar{X}_n - \mu| \geq \varepsilon) \leq \frac{\sigma^2}{n\varepsilon^2} Pr ( ∣ X ˉ n − μ ∣ ≥ ε ) ≤ n ε 2 σ 2 です。
Var ( X ˉ n ) \operatorname{Var}(\bar{X}_n) Var ( X ˉ n )
例への適用 1 回の試行の分散は σ 2 = p ( 1 − p ) \sigma^2 = p(1-p) σ 2 = p ( 1 − p ) δ \delta δ
n ≥ p ( 1 − p ) ε 2 δ n \geq \frac{p(1-p)}{\varepsilon^2 \delta} n ≥ ε 2 δ p ( 1 − p ) とすれば十分です。
(A) で δ = 0.05 \delta = 0.05 δ = 0.05 n ≥ 2,000 n \geq 2{,}000 n ≥ 2 , 000 n n n 1 / δ 1/\delta 1/ δ δ = 10 − 6 \delta = 10^{-6} δ = 1 0 − 6 n ≥ 10 8 n \geq 10^8 n ≥ 1 0 8
4. Chernoff 法
Chebyshev の不等式の上界は t t t t t t
一般形
λ ∈ R \lambda \in \mathbb{R} λ ∈ R E [ e λ X ] \mathbb{E}[e^{\lambda X}] E [ e λ X ] X X X 積率母関数(moment generating function; MGF) と呼びます。
本記事では、中心化した確率変数の MGF の対数
ψ X ( λ ) : = log E [ e λ ( X − E [ X ] ) ] \psi_X(\lambda) := \log \mathbb{E}\left[e^{\lambda (X - \mathbb{E}[X])}\right] ψ X ( λ ) := log E [ e λ ( X − E [ X ]) ] を使います。
λ > 0 \lambda > 0 λ > 0 ψ X ( λ ) \psi_X(\lambda) ψ X ( λ ) x ↦ e λ x x \mapsto e^{\lambda x} x ↦ e λ x
Pr ( X − E [ X ] ≥ t ) = Pr ( e λ ( X − E [ X ] ) ≥ e λ t ) ≤ e − λ t E [ e λ ( X − E [ X ] ) ] = exp ( − λ t + ψ X ( λ ) ) \begin{aligned}
\Pr(X - \mathbb{E}[X] \geq t)
&= \Pr\left(e^{\lambda (X - \mathbb{E}[X])} \geq e^{\lambda t}\right) \\
&\leq e^{-\lambda t}\, \mathbb{E}\left[e^{\lambda (X - \mathbb{E}[X])}\right]
= \exp\left(-\lambda t + \psi_X(\lambda)\right)
\end{aligned} Pr ( X − E [ X ] ≥ t ) = Pr ( e λ ( X − E [ X ]) ≥ e λ t ) ≤ e − λ t E [ e λ ( X − E [ X ]) ] = exp ( − λ t + ψ X ( λ ) ) が成り立ちます。
この式は ψ X ( λ ) \psi_X(\lambda) ψ X ( λ ) λ > 0 \lambda > 0 λ > 0 λ \lambda λ
Pr ( X − E [ X ] ≥ t ) ≤ exp ( − sup λ > 0 { λ t − ψ X ( λ ) } ) \Pr(X - \mathbb{E}[X] \geq t) \leq \exp\left(-\sup_{\lambda > 0} \left\{\lambda t - \psi_X(\lambda)\right\}\right) Pr ( X − E [ X ] ≥ t ) ≤ exp ( − λ > 0 sup { λ t − ψ X ( λ ) } ) を得ます。
この上界を Chernoff bound と呼びます。
ψ X \psi_X ψ X − X -X − X
独立な確率変数の和
指数関数を使うと、独立な確率変数の和の MGF は、各変数の MGF の積に分解されます。
X 1 , … , X n X_1, \dots, X_n X 1 , … , X n
E [ e λ ( S n − E [ S n ] ) ] = ∏ i = 1 n E [ e λ ( X i − E [ X i ] ) ] \mathbb{E}\left[e^{\lambda (S_n - \mathbb{E}[S_n])}\right] = \prod_{i=1}^n \mathbb{E}\left[e^{\lambda (X_i - \mathbb{E}[X_i])}\right] E [ e λ ( S n − E [ S n ]) ] = i = 1 ∏ n E [ e λ ( X i − E [ X i ]) ] であり、両辺の対数をとると ψ S n ( λ ) = ∑ i = 1 n ψ X i ( λ ) \psi_{S_n}(\lambda) = \sum_{i=1}^n \psi_{X_i}(\lambda) ψ S n ( λ ) = ∑ i = 1 n ψ X i ( λ ) X i X_i X i ψ X i \psi_{X_i} ψ X i S n S_n S n
sub-Gaussian
ある ν > 0 \nu > 0 ν > 0 λ ∈ R \lambda \in \mathbb{R} λ ∈ R
ψ X ( λ ) ≤ ν λ 2 2 \psi_X(\lambda) \leq \frac{\nu \lambda^2}{2} ψ X ( λ ) ≤ 2 ν λ 2 が成り立つとき、X X X ν \nu ν sub-Gaussian であるといいます。
分散 ν \nu ν ψ X ( λ ) = ν λ 2 / 2 \psi_X(\lambda) = \nu\lambda^2/2 ψ X ( λ ) = ν λ 2 /2 X X X λ t − ν λ 2 / 2 \lambda t - \nu\lambda^2/2 λ t − ν λ 2 /2 λ = t / ν \lambda = t/\nu λ = t / ν t 2 / ( 2 ν ) t^2/(2\nu) t 2 / ( 2 ν )
Pr ( X − E [ X ] ≥ t ) ≤ exp ( − t 2 2 ν ) \Pr(X - \mathbb{E}[X] \geq t) \leq \exp\left(-\frac{t^2}{2\nu}\right) Pr ( X − E [ X ] ≥ t ) ≤ exp ( − 2 ν t 2 ) を得ます。
定義は λ < 0 \lambda < 0 λ < 0 2 2 2
また、独立な X i X_i X i ν i \nu_i ν i ψ S n = ∑ i ψ X i \psi_{S_n} = \sum_i \psi_{X_i} ψ S n = ∑ i ψ X i S n S_n S n ∑ i = 1 n ν i \sum_{i=1}^n \nu_i ∑ i = 1 n ν i
Bernoulli 確率変数の和に対する相対誤差の上界
Chernoff 法を Bernoulli 確率変数の和に適用すると、期待値に対する相対誤差の上界が得られます(Mitzenmacher & Upfal, 2017, 第 4 章)。
定理 3(相対誤差の Chernoff bound)
X 1 , … , X n X_1, \dots, X_n X 1 , … , X n X i ∈ { 0 , 1 } X_i \in \{0, 1\} X i ∈ { 0 , 1 } Pr ( X i = 1 ) = p i \Pr(X_i = 1) = p_i Pr ( X i = 1 ) = p i m : = E [ S n ] = ∑ i = 1 n p i m := \mathbb{E}[S_n] = \sum_{i=1}^n p_i m := E [ S n ] = ∑ i = 1 n p i η > 0 \eta > 0 η > 0
Pr ( S n ≥ ( 1 + η ) m ) ≤ ( e η ( 1 + η ) 1 + η ) m ≤ exp ( − η 2 m 2 + η ) \begin{aligned}
\Pr\left(S_n \geq (1 + \eta) m\right)
&\leq \left(\frac{e^{\eta}}{(1 + \eta)^{1 + \eta}}\right)^m \\
&\leq \exp\left(-\frac{\eta^2 m}{2 + \eta}\right)
\end{aligned} Pr ( S n ≥ ( 1 + η ) m ) ≤ ( ( 1 + η ) 1 + η e η ) m ≤ exp ( − 2 + η η 2 m ) が成り立ちます。
また、0 < η < 1 0 < \eta < 1 0 < η < 1
Pr ( S n ≤ ( 1 − η ) m ) ≤ exp ( − η 2 m 2 ) \Pr\left(S_n \leq (1 - \eta) m\right) \leq \exp\left(-\frac{\eta^2 m}{2}\right) Pr ( S n ≤ ( 1 − η ) m ) ≤ exp ( − 2 η 2 m ) が成り立ちます。
1 つ目の式の 2 番目の不等号は、η ≥ 0 \eta \geq 0 η ≥ 0 log ( 1 + η ) ≥ 2 η / ( 2 + η ) \log(1 + \eta) \geq 2\eta/(2 + \eta) log ( 1 + η ) ≥ 2 η / ( 2 + η ) m m m η \eta η m m m n n n
例への適用 p i = p p_i = p p i = p m = n p m = np m = n p ∣ p ^ − p ∣ ≥ ε |\hat{p} - p| \geq \varepsilon ∣ p ^ − p ∣ ≥ ε η : = ε / p \eta := \varepsilon/p η := ε / p η < 1 \eta < 1 η < 1 η 2 m / 2 \eta^2 m/2 η 2 m /2 η 2 m / ( 2 + η ) \eta^2 m/(2 + \eta) η 2 m / ( 2 + η )
Pr ( ∣ p ^ − p ∣ ≥ ε ) ≤ 2 exp ( − η 2 n p 2 + η ) \Pr(|\hat{p} - p| \geq \varepsilon) \leq 2\exp\left(-\frac{\eta^2 np}{2 + \eta}\right) Pr ( ∣ p ^ − p ∣ ≥ ε ) ≤ 2 exp ( − 2 + η η 2 n p ) です。
右辺を δ \delta δ n ≥ ( 2 + η ) log ( 2 / δ ) / ( η 2 p ) n \geq (2 + \eta)\log(2/\delta) / (\eta^2 p) n ≥ ( 2 + η ) log ( 2/ δ ) / ( η 2 p ) η = 0.5 \eta = 0.5 η = 0.5 δ = 0.05 \delta = 0.05 δ = 0.05 n ≥ 3,689 n \geq 3{,}689 n ≥ 3 , 689
5. Hoeffding の不等式
独立な確率変数がそれぞれ既知の有界区間に値をとるとき、Chernoff 法から Hoeffding の不等式が導かれます(Hoeffding, 1963)。
鍵になるのは、有界な確率変数が sub-Gaussian であることを示す次の補題です。
a ≤ X ≤ b a \leq X \leq b a ≤ X ≤ b λ ∈ R \lambda \in \mathbb{R} λ ∈ R
ψ X ( λ ) ≤ λ 2 ( b − a ) 2 8 \psi_X(\lambda) \leq \frac{\lambda^2 (b - a)^2}{8} ψ X ( λ ) ≤ 8 λ 2 ( b − a ) 2 が成り立ちます。
つまり、X X X ( b − a ) 2 / 4 (b - a)^2/4 ( b − a ) 2 /4
証明は Boucheron et al. (2013) の第 2 章を参照してください。
X 1 , … , X n X_1, \dots, X_n X 1 , … , X n i i i a i ≤ X i ≤ b i a_i \leq X_i \leq b_i a i ≤ X i ≤ b i t > 0 t > 0 t > 0
Pr ( S n − E [ S n ] ≥ t ) ≤ exp ( − 2 t 2 ∑ i = 1 n ( b i − a i ) 2 ) \Pr(S_n - \mathbb{E}[S_n] \geq t) \leq \exp\left(-\frac{2t^2}{\sum_{i=1}^n (b_i - a_i)^2}\right) Pr ( S n − E [ S n ] ≥ t ) ≤ exp ( − ∑ i = 1 n ( b i − a i ) 2 2 t 2 ) が成り立ちます。
下側の裾確率にも同じ上界が成り立ち、両側の裾確率の上界は右辺の 2 倍です。
証明 Hoeffding の補題より、各 X i X_i X i ( b i − a i ) 2 / 4 (b_i - a_i)^2/4 ( b i − a i ) 2 /4 S n S_n S n ν : = ∑ i = 1 n ( b i − a i ) 2 / 4 \nu := \sum_{i=1}^n (b_i - a_i)^2/4 ν := ∑ i = 1 n ( b i − a i ) 2 /4
Pr ( S n − E [ S n ] ≥ t ) ≤ exp ( − t 2 2 ν ) = exp ( − 2 t 2 ∑ i = 1 n ( b i − a i ) 2 ) \begin{aligned}
\Pr(S_n - \mathbb{E}[S_n] \geq t)
&\leq \exp\left(-\frac{t^2}{2\nu}\right) \\
&= \exp\left(-\frac{2t^2}{\sum_{i=1}^n (b_i - a_i)^2}\right)
\end{aligned} Pr ( S n − E [ S n ] ≥ t ) ≤ exp ( − 2 ν t 2 ) = exp ( − ∑ i = 1 n ( b i − a i ) 2 2 t 2 ) を得ます。□ \square □
標本平均と必要な標本数
各 X i ∈ [ a , b ] X_i \in [a, b] X i ∈ [ a , b ] μ \mu μ t = n ε t = n\varepsilon t = n ε
Pr ( ∣ X ˉ n − μ ∣ ≥ ε ) ≤ 2 exp ( − 2 n ε 2 ( b − a ) 2 ) \Pr(|\bar{X}_n - \mu| \geq \varepsilon) \leq 2\exp\left(-\frac{2n\varepsilon^2}{(b - a)^2}\right) Pr ( ∣ X ˉ n − μ ∣ ≥ ε ) ≤ 2 exp ( − ( b − a ) 2 2 n ε 2 ) を得ます。
ε \varepsilon ε n n n σ 2 / ( n ε 2 ) \sigma^2/(n\varepsilon^2) σ 2 / ( n ε 2 ) 1 / n 1/n 1/ n
右辺を δ \delta δ
n ≥ ( b − a ) 2 2 ε 2 log 2 δ n \geq \dfrac{(b - a)^2}{2\varepsilon^2} \log\dfrac{2}{\delta} n ≥ 2 ε 2 ( b − a ) 2 log δ 2 Pr ( ∣ X ˉ n − μ ∣ ≥ ε ) ≤ δ \Pr(|\bar{X}_n - \mu| \geq \varepsilon) \leq \delta Pr ( ∣ X ˉ n − μ ∣ ≥ ε ) ≤ δ 任意の n n n 1 − δ 1 - \delta 1 − δ ∣ X ˉ n − μ ∣ < ( b − a ) log ( 2 / δ ) 2 n |\bar{X}_n - \mu| < (b - a)\sqrt{\dfrac{\log(2/\delta)}{2n}} ∣ X ˉ n − μ ∣ < ( b − a ) 2 n log ( 2/ δ )
例への適用 X i ∈ [ 0 , 1 ] X_i \in [0, 1] X i ∈ [ 0 , 1 ] n ≥ log ( 2 / δ ) / ( 2 ε 2 ) n \geq \log(2/\delta)/(2\varepsilon^2) n ≥ log ( 2/ δ ) / ( 2 ε 2 ) δ = 0.05 \delta = 0.05 δ = 0.05 n ≥ 738 n \geq 738 n ≥ 738 δ = 10 − 6 \delta = 10^{-6} δ = 1 0 − 6 n ≥ 2,902 n \geq 2{,}902 n ≥ 2 , 902 n n n log ( 1 / δ ) \log(1/\delta) log ( 1/ δ ) 1 / δ 1/\delta 1/ δ δ \delta δ δ = 0.05 \delta = 0.05 δ = 0.05 n ≥ 73,778 n \geq 73{,}778 n ≥ 73 , 778 [ 0 , 1 ] [0, 1] [ 0 , 1 ] p ( 1 − p ) ≈ 0.0099 p(1-p) \approx 0.0099 p ( 1 − p ) ≈ 0.0099 [ 0 , 1 ] [0, 1] [ 0 , 1 ] 1 / 4 1/4 1/4 1 / 25 1/25 1/25
定理 4 の a i , b i a_i, b_i a i , b i min i X i \min_i X_i min i X i max i X i \max_i X_i max i X i
6. Bernstein の不等式
Hoeffding の不等式は値域しか使いません。
値域が広くても、ほとんどの値が期待値の近くに集まる確率変数では、分散も使う Bernstein の不等式がより小さい上界を与えます(Boucheron et al., 2013, §2.8)。
X 1 , … , X n X_1, \dots, X_n X 1 , … , X n M > 0 M > 0 M > 0 i i i ∣ X i − E [ X i ] ∣ ≤ M |X_i - \mathbb{E}[X_i]| \leq M ∣ X i − E [ X i ] ∣ ≤ M V : = ∑ i = 1 n Var ( X i ) V := \sum_{i=1}^n \operatorname{Var}(X_i) V := ∑ i = 1 n Var ( X i ) t > 0 t > 0 t > 0
Pr ( S n − E [ S n ] ≥ t ) ≤ exp ( − t 2 2 ( V + M t / 3 ) ) \Pr(S_n - \mathbb{E}[S_n] \geq t) \leq \exp\left(-\frac{t^2}{2(V + Mt/3)}\right) Pr ( S n − E [ S n ] ≥ t ) ≤ exp ( − 2 ( V + M t /3 ) t 2 ) が成り立ちます。
下側の裾確率にも同じ上界が成り立ち、両側の裾確率の上界は右辺の 2 倍です。
2 つの減衰の速さ
分母の V + M t / 3 V + Mt/3 V + M t /3 V + M t / 3 ≤ 2 max { V , M t / 3 } V + Mt/3 \leq 2\max\{V, Mt/3\} V + M t /3 ≤ 2 max { V , M t /3 }
exp ( − t 2 2 ( V + M t / 3 ) ) ≤ exp ( − min { t 2 4 V , 3 t 4 M } ) \exp\left(-\frac{t^2}{2(V + Mt/3)}\right) \leq \exp\left(-\min\left\{\frac{t^2}{4V}, \frac{3t}{4M}\right\}\right) exp ( − 2 ( V + M t /3 ) t 2 ) ≤ exp ( − min { 4 V t 2 , 4 M 3 t } ) が成り立ちます。
t ≤ 3 V / M t \leq 3V/M t ≤ 3 V / M t 2 / ( 4 V ) t^2/(4V) t 2 / ( 4 V ) V V V t 2 t^2 t 2 t > 3 V / M t > 3V/M t > 3 V / M 3 t / ( 4 M ) 3t/(4M) 3 t / ( 4 M ) t t t
標本平均と Hoeffding の不等式との比較
X 1 , … , X n X_1, \dots, X_n X 1 , … , X n E [ X i ] = μ \mathbb{E}[X_i] = \mu E [ X i ] = μ Var ( X i ) = σ 2 \operatorname{Var}(X_i) = \sigma^2 Var ( X i ) = σ 2 ∣ X i − μ ∣ ≤ M |X_i - \mu| \leq M ∣ X i − μ ∣ ≤ M V = n σ 2 V = n\sigma^2 V = n σ 2 t = n ε t = n\varepsilon t = n ε
Pr ( ∣ X ˉ n − μ ∣ ≥ ε ) ≤ 2 exp ( − n ε 2 2 ( σ 2 + M ε / 3 ) ) \Pr(|\bar{X}_n - \mu| \geq \varepsilon) \leq 2\exp\left(-\frac{n\varepsilon^2}{2(\sigma^2 + M\varepsilon/3)}\right) Pr ( ∣ X ˉ n − μ ∣ ≥ ε ) ≤ 2 exp ( − 2 ( σ 2 + M ε /3 ) n ε 2 ) を得ます。
X i ∈ [ a , b ] X_i \in [a, b] X i ∈ [ a , b ] ( b − a ) 2 / 4 (b - a)^2/4 ( b − a ) 2 /4 σ 2 \sigma^2 σ 2 M ε / 3 M\varepsilon/3 M ε /3 2 n ε 2 / ( b − a ) 2 2n\varepsilon^2/(b - a)^2 2 n ε 2 / ( b − a ) 2 σ 2 + M ε / 3 < ( b − a ) 2 / 4 \sigma^2 + M\varepsilon/3 < (b - a)^2/4 σ 2 + M ε /3 < ( b − a ) 2 /4
例への適用 σ 2 = p ( 1 − p ) \sigma^2 = p(1-p) σ 2 = p ( 1 − p ) M = max { p , 1 − p } M = \max\{p, 1 - p\} M = max { p , 1 − p }
n ≥ 2 ( σ 2 + M ε / 3 ) ε 2 log 2 δ n \geq \frac{2(\sigma^2 + M\varepsilon/3)}{\varepsilon^2} \log\frac{2}{\delta} n ≥ ε 2 2 ( σ 2 + M ε /3 ) log δ 2 です。
(B) で δ = 0.05 \delta = 0.05 δ = 0.05 n ≥ 3,409 n \geq 3{,}409 n ≥ 3 , 409 73,778 73{,}778 73 , 778 1 / 22 1/22 1/22 σ 2 = 1 / 4 \sigma^2 = 1/4 σ 2 = 1/4 n ≥ 763 n \geq 763 n ≥ 763 738 738 738
7. McDiarmid の不等式
第 5 節と第 6 節では、確率変数の和を扱いました。
McDiarmid の不等式(有界差分不等式、bounded differences inequality)は、和に限らず、独立な確率変数の関数 f ( X 1 , … , X n ) f(X_1, \dots, X_n) f ( X 1 , … , X n )
関数 f : X 1 × ⋯ × X n → R f: \mathcal{X}_1 \times \cdots \times \mathcal{X}_n \to \mathbb{R} f : X 1 × ⋯ × X n → R c 1 , … , c n ≥ 0 c_1, \dots, c_n \geq 0 c 1 , … , c n ≥ 0 i i i i i i
∣ f ( x 1 , … , x i , … , x n ) − f ( x 1 , … , x i ′ , … , x n ) ∣ ≤ c i \left|f(x_1, \dots, x_i, \dots, x_n) - f(x_1, \dots, x_i', \dots, x_n)\right| \leq c_i ∣ f ( x 1 , … , x i , … , x n ) − f ( x 1 , … , x i ′ , … , x n ) ∣ ≤ c i を満たすとき、f f f 有界差分条件(bounded differences condition) を満たすといいます。
有界差分条件は、i i i c i c_i c i
X 1 , … , X n X_1, \dots, X_n X 1 , … , X n X i X_i X i X i \mathcal{X}_i X i f f f c 1 , … , c n c_1, \dots, c_n c 1 , … , c n Z : = f ( X 1 , … , X n ) Z := f(X_1, \dots, X_n) Z := f ( X 1 , … , X n ) t > 0 t > 0 t > 0
Pr ( Z − E [ Z ] ≥ t ) ≤ exp ( − 2 t 2 ∑ i = 1 n c i 2 ) \Pr(Z - \mathbb{E}[Z] \geq t) \leq \exp\left(-\frac{2t^2}{\sum_{i=1}^n c_i^2}\right) Pr ( Z − E [ Z ] ≥ t ) ≤ exp ( − ∑ i = 1 n c i 2 2 t 2 ) が成り立ちます。
下側の裾確率にも同じ上界が成り立ち、両側の裾確率の上界は右辺の 2 倍です。
Hoeffding の不等式との関係
f f f f ( x 1 , … , x n ) = ∑ i = 1 n x i f(x_1, \dots, x_n) = \sum_{i=1}^n x_i f ( x 1 , … , x n ) = ∑ i = 1 n x i x i ∈ [ a i , b i ] x_i \in [a_i, b_i] x i ∈ [ a i , b i ] i i i b i − a i b_i - a_i b i − a i c i = b i − a i c_i = b_i - a_i c i = b i − a i
例:経験分布関数の一様な誤差
和ではない関数の例として、X 1 , … , X n X_1, \dots, X_n X 1 , … , X n F F F F n ( x ) : = 1 n ∑ i = 1 n 1 { X i ≤ x } F_n(x) := \frac{1}{n} \sum_{i=1}^n \mathbf{1}_{\{X_i \leq x\}} F n ( x ) := n 1 ∑ i = 1 n 1 { X i ≤ x } F F F
Z : = sup x ∈ R ∣ F n ( x ) − F ( x ) ∣ Z := \sup_{x \in \mathbb{R}} |F_n(x) - F(x)| Z := x ∈ R sup ∣ F n ( x ) − F ( x ) ∣ を考えます。
Z Z Z F F F X i X_i X i x x x F n ( x ) F_n(x) F n ( x ) 1 / n 1/n 1/ n Z Z Z 1 / n 1/n 1/ n c i = 1 / n c_i = 1/n c i = 1/ n ∑ i = 1 n c i 2 = 1 / n \sum_{i=1}^n c_i^2 = 1/n ∑ i = 1 n c i 2 = 1/ n
Pr ( Z − E [ Z ] ≥ t ) ≤ e − 2 n t 2 \Pr(Z - \mathbb{E}[Z] \geq t) \leq e^{-2nt^2} Pr ( Z − E [ Z ] ≥ t ) ≤ e − 2 n t 2 です。
Z Z Z n n n F F F
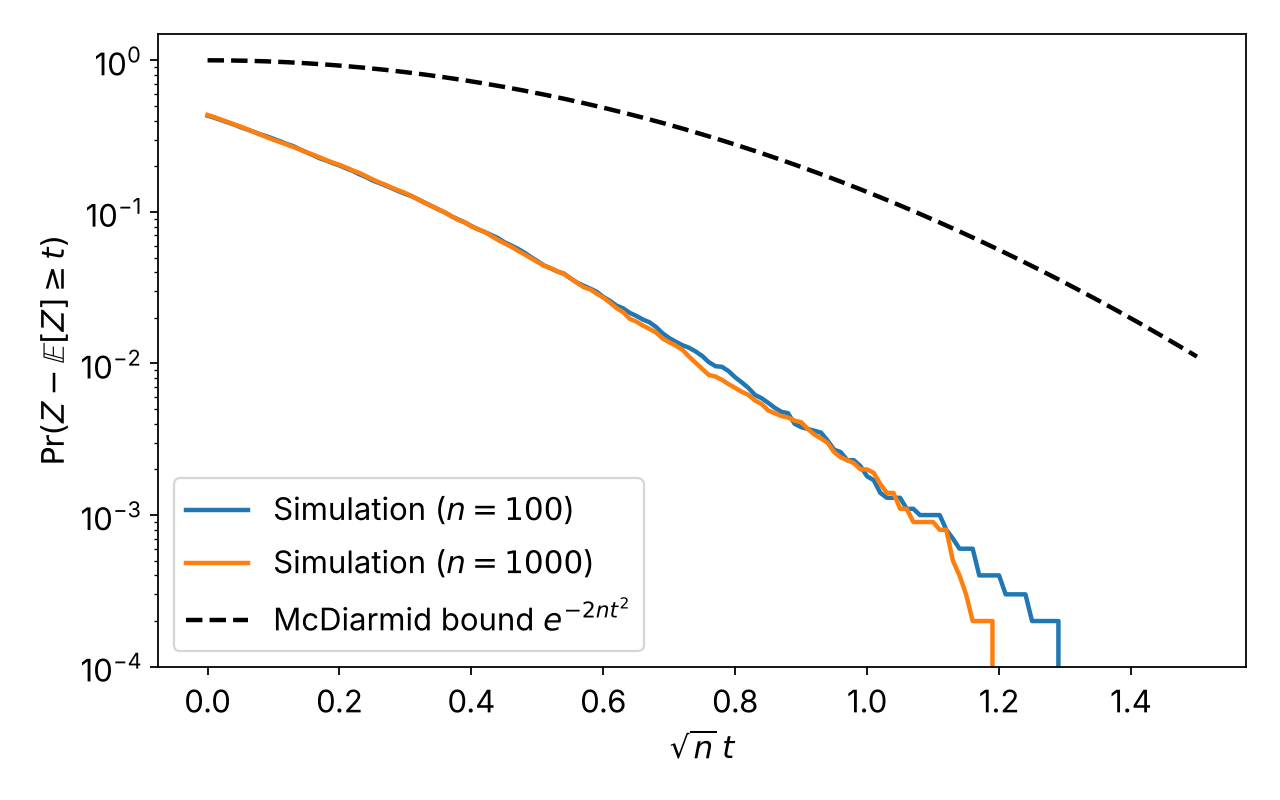
この上界を Python で確かめます。
次のコードは、一様分布 U n i f o r m ( 0 , 1 ) \mathrm{Uniform}(0, 1) Uniform ( 0 , 1 ) F ( x ) = x F(x) = x F ( x ) = x n = 100 , 1000 n = 100, 1000 n = 100 , 1000 10 4 10^4 1 0 4 Z Z Z Pr ( Z − E [ Z ] ≥ t ) \Pr(Z - \mathbb{E}[Z] \geq t) Pr ( Z − E [ Z ] ≥ t ) E [ Z ] \mathbb{E}[Z] E [ Z ] 10 4 10^4 1 0 4
import numpy as np
import matplotlib . pyplot as plt
rng = np . random . default_rng ( 0 )
reps = 10_000
s = np . linspace ( 0 , 1.5 , 151 ) # 横軸は sqrt(n) * t
for n in [ 100 , 1000 ] :
# Uniform(0, 1) の標本を reps 組生成し、各組を昇順に並べる
u = np . sort ( rng . random ( ( reps , n ) ) , axis = 1 )
i = np . arange ( 1 , n + 1 )
# Z = sup_x |F_n(x) - x|(経験分布関数と真の分布関数 F(x) = x の差の最大値)
z = np . maximum ( i / n - u , u - ( i - 1 ) / n ) . max ( axis = 1 )
tail = [ np . mean ( z - z . mean ( ) >= x / np . sqrt ( n ) ) for x in s ]
plt . semilogy ( s , tail , lw = 2 , label = f"Simulation ($n = { n } $)" )
plt . semilogy ( s , np . exp ( - 2 * s ** 2 ) , "k--" , lw = 2 ,
label = r"McDiarmid bound $e^{-2nt^2}$" )
plt . ylim ( 1e-4 , 1.5 )
plt . xlabel ( r"$\sqrt{n}\,t$" )
plt . ylabel ( r"$\Pr(Z - \mathbb{E}[Z] \geq t)$" )
plt . legend ( )
plt . show ( ) 図 3:Kolmogorov–Smirnov 統計量 Z の上側の裾確率(シミュレーション)と McDiarmid の上界。横軸を √n t とすると、上界は n によらない 1 本の曲線になる。縦軸は対数目盛。 横軸を n t \sqrt{n}\, t n t e − 2 n t 2 = e − 2 ( n t ) 2 e^{-2nt^2} = e^{-2(\sqrt{n}\, t)^2} e − 2 n t 2 = e − 2 ( n t ) 2 n n n n = 100 n = 100 n = 100 n = 1000 n = 1000 n = 1000 Z − E [ Z ] Z - \mathbb{E}[Z] Z − E [ Z ] 1 / n 1/\sqrt{n} 1/ n
機械学習でも同じ構造が現れます。
値が [ 0 , 1 ] [0, 1] [ 0 , 1 ] G \mathcal{G} G sup g ∈ G ∣ 1 n ∑ i = 1 n g ( X i ) − E [ g ( X 1 ) ] ∣ \sup_{g \in \mathcal{G}} \left|\frac{1}{n} \sum_{i=1}^n g(X_i) - \mathbb{E}[g(X_1)]\right| sup g ∈ G n 1 ∑ i = 1 n g ( X i ) − E [ g ( X 1 )] c i = 1 / n c_i = 1/n c i = 1/ n
コラム:証明の考え方(martingale による分解)
McDiarmid の不等式は、Z − E [ Z ] Z - \mathbb{E}[Z] Z − E [ Z ] X 1 , X 2 , … X_1, X_2, \dots X 1 , X 2 , … Y 0 : = E [ Z ] Y_0 := \mathbb{E}[Z] Y 0 := E [ Z ] k = 1 , … , n k = 1, \dots, n k = 1 , … , n
Y k : = E [ Z ∣ X 1 , … , X k ] Y_k := \mathbb{E}[Z \mid X_1, \dots, X_k] Y k := E [ Z ∣ X 1 , … , X k ] とおくと、Y n = Z Y_n = Z Y n = Z
Z − E [ Z ] = ∑ k = 1 n ( Y k − Y k − 1 ) Z - \mathbb{E}[Z] = \sum_{k=1}^n (Y_k - Y_{k-1}) Z − E [ Z ] = k = 1 ∑ n ( Y k − Y k − 1 ) と書けます。
X 1 , … , X k − 1 X_1, \dots, X_{k-1} X 1 , … , X k − 1 Y k − Y k − 1 Y_k - Y_{k-1} Y k − Y k − 1 0 0 0 ( Y k ) (Y_k) ( Y k ) martingale と呼びます。
さらに、独立性と有界差分条件から、X 1 , … , X k − 1 X_1, \dots, X_{k-1} X 1 , … , X k − 1 Y k Y_k Y k X k X_k X k c k c_k c k k = n , n − 1 , … , 1 k = n, n-1, \dots, 1 k = n , n − 1 , … , 1
E [ e λ ( Z − E [ Z ] ) ] ≤ exp ( λ 2 8 ∑ k = 1 n c k 2 ) \mathbb{E}\left[e^{\lambda (Z - \mathbb{E}[Z])}\right] \leq \exp\left(\frac{\lambda^2}{8} \sum_{k=1}^n c_k^2\right) E [ e λ ( Z − E [ Z ]) ] ≤ exp ( 8 λ 2 k = 1 ∑ n c k 2 ) を得ます。
つまり、Z Z Z ∑ k c k 2 / 4 \sum_k c_k^2/4 ∑ k c k 2 /4
8. 比較と使い分け
例の結果
第 3 節から第 6 節で求めた、Pr ( ∣ p ^ − p ∣ ≥ ε ) ≤ δ \Pr(|\hat{p} - p| \geq \varepsilon) \leq \delta Pr ( ∣ p ^ − p ∣ ≥ ε ) ≤ δ p ( 1 − p ) p(1-p) p ( 1 − p ) p p p p ≤ 0.01 p \leq 0.01 p ≤ 0.01 0.0099 0.0099 0.0099
表 1 :Pr ( ∣ p ^ − p ∣ ≥ ε ) ≤ δ \Pr(|\hat{p} - p| \geq \varepsilon) \leq \delta Pr ( ∣ p ^ − p ∣ ≥ ε ) ≤ δ n n n
不等式 使う情報 (A) δ = 0.05 \delta = 0.05 δ = 0.05 (A) δ = 10 − 6 \delta = 10^{-6} δ = 1 0 − 6 (B) δ = 0.05 \delta = 0.05 δ = 0.05 (B) δ = 10 − 6 \delta = 10^{-6} δ = 1 0 − 6 Chebyshev(第 3 節) 分散 2,000 100,000,000 7,920 396,000,000 相対誤差の Chernoff bound(第 4 節) Bernoulli 和の期待値 1,550 6,094 3,689 14,509 Hoeffding(第 5 節) 値域 738 2,902 73,778 290,174 Bernstein(第 6 節) 値域、分散 763 2,999 3,409 13,406 二項分布から計算した値 分布そのもの 約 400 約 2,400 約 1,600 約 10,400
最終行は、その値以上のすべての n n n Pr ( ∣ p ^ − p ∣ ≥ ε ) ≤ δ \Pr(|\hat{p} - p| \geq \varepsilon) \leq \delta Pr ( ∣ p ^ − p ∣ ≥ ε ) ≤ δ n n n n ( p ± ε ) n(p \pm \varepsilon) n ( p ± ε ) n n n ∣ p ^ − p ∣ = ε |\hat{p} - p| = \varepsilon ∣ p ^ − p ∣ = ε n n n
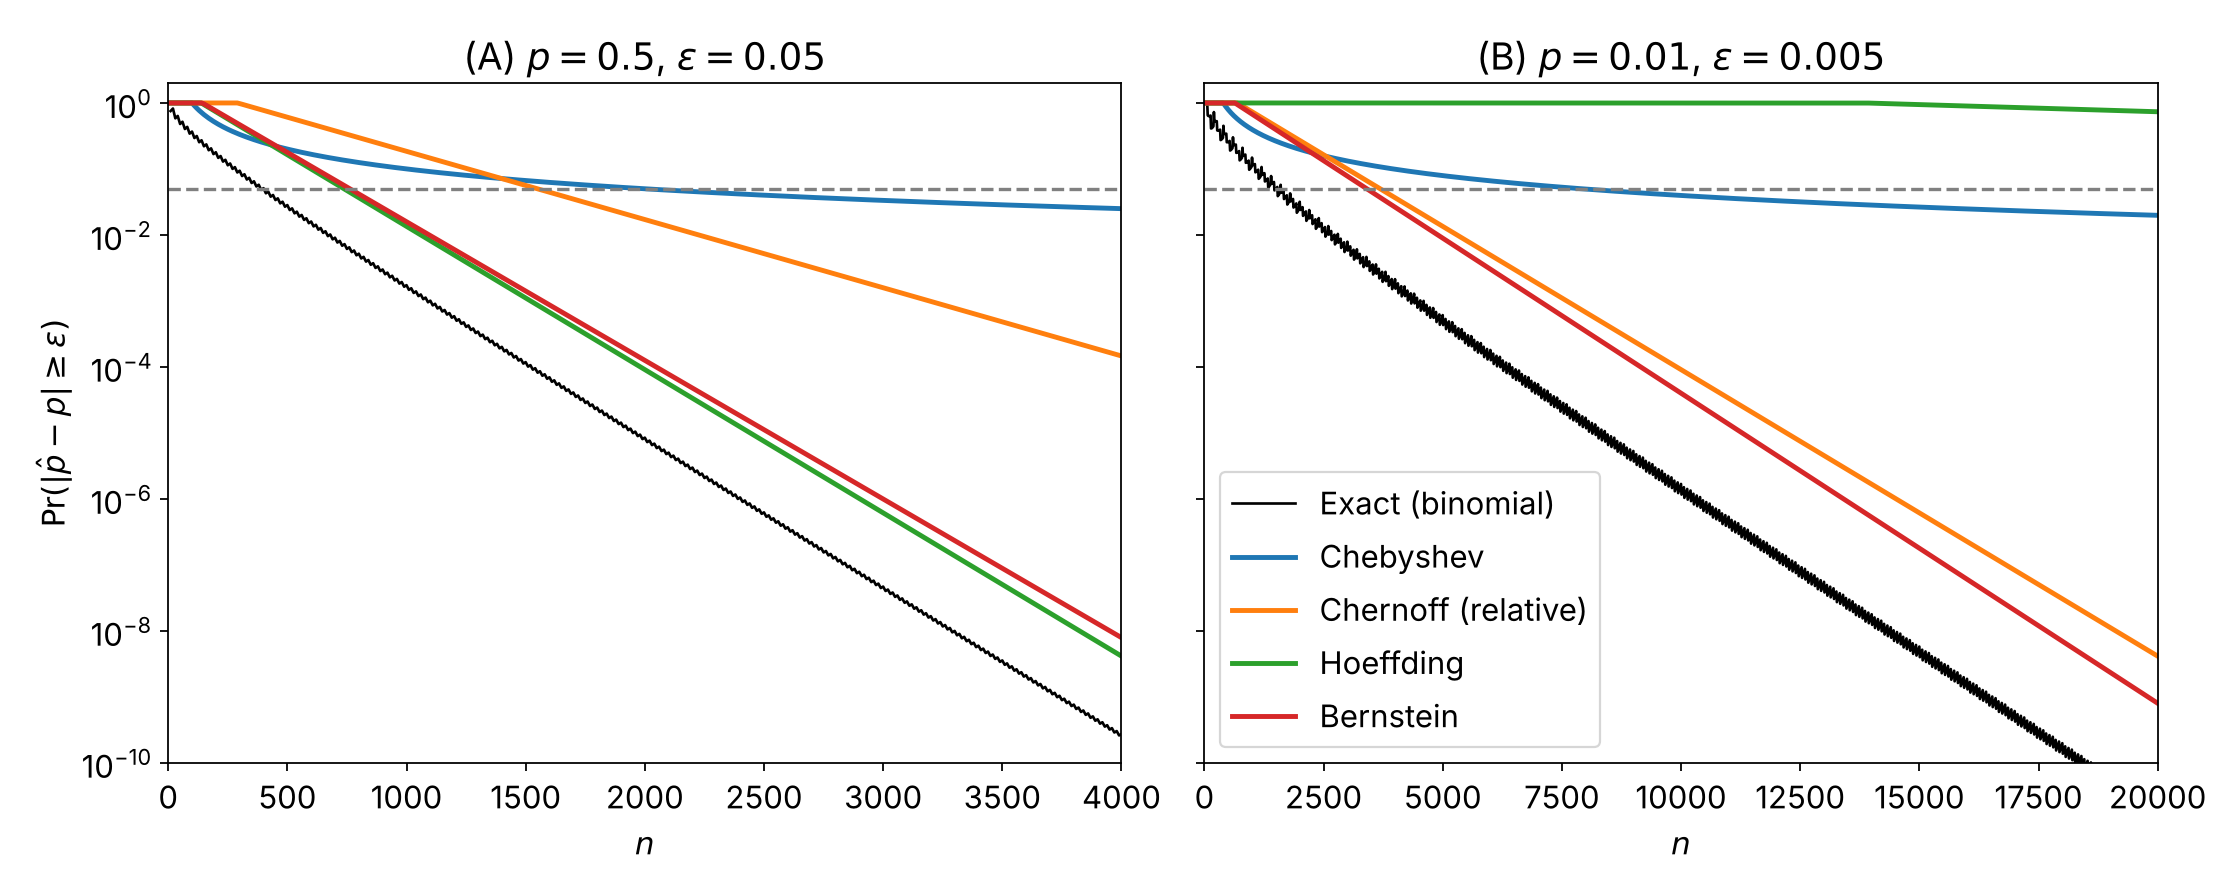
次のコードは、二項分布から計算した Pr ( ∣ p ^ − p ∣ ≥ ε ) \Pr(|\hat{p} - p| \geq \varepsilon) Pr ( ∣ p ^ − p ∣ ≥ ε ) n n n
import numpy as np
import matplotlib . pyplot as plt
from scipy . stats import binom
def exact_tail ( n , p , eps ) :
"""S ~ Bin(n, p) について Pr(|S/n - p| >= eps) を計算する"""
# 1e-9 は浮動小数点の丸め誤差対策
upper = np . ceil ( n * ( p + eps ) - 1e-9 )
lower = np . floor ( n * ( p - eps ) + 1e-9 )
return binom . sf ( upper - 1 , n , p ) + binom . cdf ( lower , n , p )
def bounds ( n , p , eps ) :
"""各不等式による Pr(|p_hat - p| >= eps) の上界"""
var , M , eta = p * ( 1 - p ) , max ( p , 1 - p ) , eps / p
return {
"Chebyshev" : var / ( n * eps ** 2 ) ,
"Chernoff (relative)" : 2 * np . exp ( - eta ** 2 * n * p / ( 2 + eta ) ) ,
"Hoeffding" : 2 * np . exp ( - 2 * n * eps ** 2 ) ,
"Bernstein" : 2 * np . exp ( - n * eps ** 2 / ( 2 * ( var + M * eps / 3 ) ) ) ,
}
settings = [ ( "A" , 0.5 , 0.05 , 4000 ) , ( "B" , 0.01 , 0.005 , 20000 ) ]
fig , axes = plt . subplots ( 1 , 2 , figsize = ( 14 , 5.6 ) , sharey = True )
for ax , ( label , p , eps , n_max ) in zip ( axes , settings ) :
n = np . arange ( 10 , n_max + 1 , 10 )
ax . semilogy ( n , exact_tail ( n , p , eps ) , "k" , lw = 1.2 , label = "Exact (binomial)" )
for name , value in bounds ( n , p , eps ) . items ( ) :
ax . semilogy ( n , np . minimum ( value , 1 ) , lw = 2.2 , label = name )
ax . axhline ( 0.05 , color = "gray" , ls = "--" )
ax . set ( title = rf"( { label } ) $p = { p } $, $\varepsilon = { eps } $" ,
xlabel = "$n$" , xlim = ( 0 , n_max ) , ylim = ( 1e-10 , 2 ) )
axes [ 0 ] . set_ylabel ( r"$\Pr(|\hat p - p| \geq \varepsilon)$" )
axes [ 1 ] . legend ( loc = "lower left" )
plt . show ( ) 図 4:誤差確率 Pr(|p̂ − p| ≥ ε) の正確な値(黒)と、各不等式による上界。左が (A)、右が (B)。灰色の破線は δ = 0.05。縦軸は対数目盛。 表 1 と図 4 から、次の 3 点が読み取れます。
δ \delta δ δ \delta δ 0.05 0.05 0.05 10 − 6 10^{-6} 1 0 − 6 n n n 1 / δ 1/\delta 1/ δ 5 × 10 4 5 \times 10^4 5 × 1 0 4 n n n log ( 2 / δ ) \log(2/\delta) log ( 2/ δ ) 3.9 3.9 3.9 1 / n 1/n 1/ n 分散が小さいとき :(B) では、分散を使う Bernstein の不等式と、期待値に対する相対誤差を使う Chernoff bound が、値域だけを使う Hoeffding の不等式より約 20 20 20 n n n δ = 0.05 \delta = 0.05 δ = 0.05 n n n 保守性 :どの上界も実際に必要な n n n 1.2 1.2 1.2 1.8 1.8 1.8 1.3 1.3 1.3 2.1 2.1 2.1
使い分け
表 2 に、各不等式の仮定と上界をまとめます。
表 2 :各不等式の仮定と上界
不等式 主な仮定 対象 上界 Markov 非負、期待値が有限 非負の確率変数 X X X E [ X ] / t \mathbb{E}[X]/t E [ X ] / t Chebyshev 分散が有限 一般の確率変数 X X X Var ( X ) / t 2 \operatorname{Var}(X)/t^2 Var ( X ) / t 2 Chernoff 法 MGF が有限 一般の確率変数 X X X exp ( − sup λ > 0 { λ t − ψ X ( λ ) } ) \exp(-\sup_{\lambda > 0}\{\lambda t - \psi_X(\lambda)\}) exp ( − sup λ > 0 { λ t − ψ X ( λ )}) Hoeffding 独立、有界 和 S n S_n S n exp ( − 2 t 2 / ∑ i ( b i − a i ) 2 ) \exp(-2t^2/\sum_i (b_i - a_i)^2) exp ( − 2 t 2 / ∑ i ( b i − a i ) 2 ) Bernstein 独立、有界、分散 和 S n S_n S n exp ( − t 2 / ( 2 ( V + M t / 3 ) ) ) \exp(-t^2/(2(V + Mt/3))) exp ( − t 2 / ( 2 ( V + M t /3 ))) McDiarmid 独立、有界差分条件 関数 f ( X 1 , … , X n ) f(X_1, \dots, X_n) f ( X 1 , … , X n ) exp ( − 2 t 2 / ∑ i c i 2 ) \exp(-2t^2/\sum_i c_i^2) exp ( − 2 t 2 / ∑ i c i 2 )
状況に応じた選び方の目安は次のとおりです。
非負性と期待値しか分からない → Markov の不等式
分散は分かるが、独立性を仮定できない → Chebyshev の不等式(無相関なら標本平均にも使えます)
MGF を計算できる → Chernoff 法で直接評価する
独立な Bernoulli 確率変数の和で、期待値に対する相対誤差を評価したい → 相対誤差の Chernoff bound
独立な有界確率変数の和で、分散の情報がない → Hoeffding の不等式
独立な有界確率変数の和で、分散が値域に比べて小さい → Bernstein の不等式
和ではない関数で、各入力の影響が小さい → McDiarmid の不等式
9. 仮定が満たされないとき
独立でない場合
Markov の不等式と Chebyshev の不等式は、独立性を必要としません。
一方、本記事で示した形の Hoeffding、Bernstein、McDiarmid の不等式は独立性を仮定しており、依存のある確率変数にはそのまま適用できません。
ただし例外もあり、Hoeffding (1963) は、有限母集団からの非復元抽出(各標本は独立ではない)でも、復元抽出の場合と同じ上界が成り立つことを示しています。
また、増分が有界な martingale には Azuma–Hoeffding の不等式が使えます(Azuma, 1967)。
第 7 節のコラムの証明は、この不等式と同じ martingale の議論に基づいています。
有界でない場合
有界でない確率変数も集中しえます。
例えば、正規分布は有界ではありませんが、第 4 節で見たように sub-Gaussian です。
sub-Gaussian を含み、より重い裾も許す確率変数のクラスとして sub-exponential があり、Bernstein 型の上界が成り立ちます(Vershynin, 2018, 第 2 章)。
MGF が有限でない分布でも、高次のモーメントが有限なら、第 2 節の方法で t t t
10. まとめ
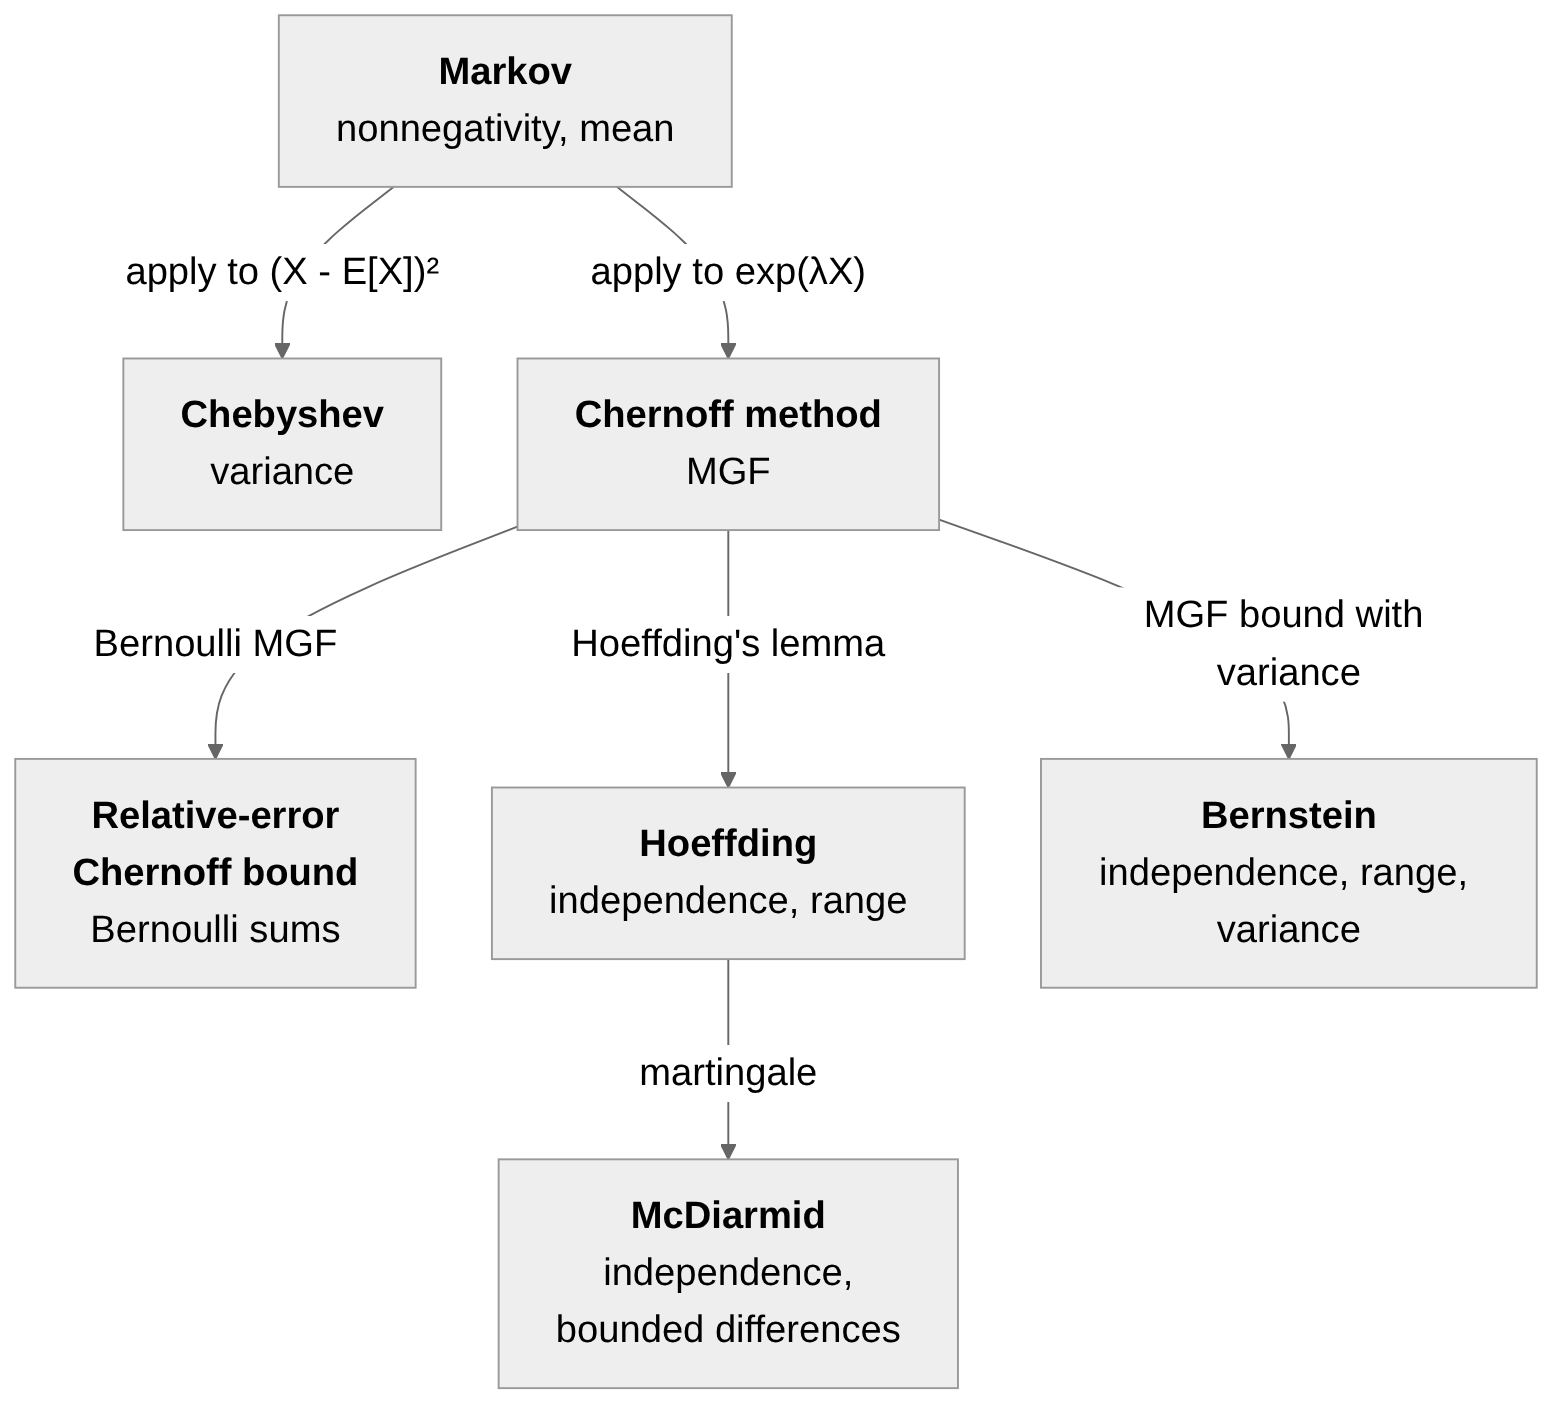
本記事で扱った不等式は、図 5 のように Markov の不等式から 2 つの経路で導かれます。
図 5:本記事で扱った不等式の関係。各箱の下段は、その不等式が使う主な仮定や情報。
Markov → Chebyshev :二乗偏差に Markov の不等式を適用し、分散で裾確率を評価します。Markov → Chernoff 法 → Hoeffding、Bernstein、McDiarmid :指数関数に Markov の不等式を適用し、MGF を評価して指数的に減少する上界を得ます。McDiarmid の不等式は、martingale による分解によって、和以外の関数にも適用できるようにした結果です。
どの不等式も、有限個のデータから作った量が期待値からどれだけ外れうるか、という問いに答えます。
第 8 節の例が示すように、どの不等式が最も小さい上界を与えるかは、使える仮定(分散、値域、独立性、関数の安定性)と問題の条件によって変わります。
References
Azuma, K. (1967). Weighted sums of certain dependent random variables . Tohoku Mathematical Journal, 19(3), 357–367.
Bartlett, P. L., & Mendelson, S. (2002). Rademacher and Gaussian complexities: Risk bounds and structural results . Journal of Machine Learning Research, 3, 463–482.
Boucheron, S., Lugosi, G., & Massart, P. (2013). Concentration Inequalities: A Nonasymptotic Theory of Independence . Oxford University Press.
Chernoff, H. (1952). A measure of asymptotic efficiency for tests of a hypothesis based on the sum of observations . The Annals of Mathematical Statistics, 23(4), 493–507.
Hoeffding, W. (1963). Probability inequalities for sums of bounded random variables . Journal of the American Statistical Association, 58(301), 13–30.
McDiarmid, C. (1989). On the method of bounded differences . In Surveys in Combinatorics, 1989 (London Mathematical Society Lecture Note Series 141), 148–188. Cambridge University Press.
Mitzenmacher, M., & Upfal, E. (2017). Probability and Computing: Randomization and Probabilistic Techniques in Algorithms and Data Analysis (2nd ed.). Cambridge University Press.
Vershynin, R. (2018). High-Dimensional Probability: An Introduction with Applications in Data Science . Cambridge University Press.